А. Ю. Смирнов, А.А. Киреева
АНО «Центр научных исследований в сфере профориентации и психологии труда», Москва, Российская Федерация
E-mail: smirnov@crcg.ru
Аннотация
Цифровая гуманитаристика накопила методы «дистантного чтения», позволяющие описывать большие текстовые массивы, но не проверять гипотезы об их структурной организации экспериментально. В статье предлагается метод контролируемой деформации (Extended Controlled Deformation Protocol, E-CDP), превращающий языковую модель в экспериментальный полигон. Исследователь направленно искажает выбранный культурный концепт в обучающем корпусе и измеряет системный отклик через панель бинарных вопросов, созданных экспертами. Количественный результат — коэффициент структурной значимости (КСЗ), отражающий степень связности понятия в данном текстовом корпусе. Метод наиболее продуктивен при сравнении множества концептов, выявляя неочевидные несущие конструкции, которые могут противоречить интуитивным ожиданиям. В статье описывается логика E-CDP, приводится иллюстративный пример сопоставления концептов в либеральном корпусе, очерчены прикладные горизонты и зафиксированы границы интерпретации. Технические протоколы, детали примеров и код вынесены в открытое онлайн-приложение, делая статью доступной для гуманитариев без специальной технической подготовки.
Ключевые слова
Цифровая гуманитаристика, большие языковые модели, контролируемая деформация, экспериментальный метод, структурная значимость концепта, дискурс-анализ, E-CDP.
The Method of Controlled Deformation of Language Models (E-CDP): An Experimental Tool for the Analysis of Macrotextual Corpora of Culture
A.U. Smirnov, A. A. Kireeva
ANO “Center for Scientific Research in Career Guidance and Labor Psychology”, Moscow, Russian Federation
E-mail: smirnov@crcg.ru
Abstract
Digital humanities has amassed an arsenal of “distant reading” methods that make it possible to describe large text collections, yet it lacks experimental means to test hypotheses about their structural organization. This article proposes a method of controlled deformation (Extended Controlled Deformation Protocol, E-CDP) that turns a language model into an experimental testbed. The researcher purposefully distorts a chosen cultural concept within the training corpus and measures the systemic response through a panel of binary questions created by experts. The quantitative outcome is the coefficient of structural significance (CSS), which reflects how deeply a concept is woven into the fabric of discourse. The method is especially productive when comparing numerous concepts, revealing non-obvious load-bearing structures that may contradict intuitive expectations. The article describes the logic of E-CDP, presents an illustrative example of contrasting concepts within a liberal corpus, outlines potential applications, and delineates the limits of interpretation. Technical protocols, detailed examples, and code are provided in an open online supplement, making the article accessible to humanities scholars without specialized technical training.
Keywords: digital humanities, large language models, controlled deformation, experimental method, structural significance of a concept, discourse analysis, E-CDP.
1. Введение
Цифровая гуманитаристика подарила исследователям возможность «дистантного чтения» — анализа тысяч текстов как единого массива. Мы научились видеть тренды, тематические сдвиги, семантические поля. Но у этих инструментов есть принципиальное ограничение: они пассивны. Мы можем зафиксировать, что в советской публицистике «классовая борьба» упоминается чаще, чем «права человека», но не можем спросить: была ли «классовая борьба» действительной несущей конструкцией дискурса или просто частотным маркером?
Большие языковые модели (LLM) дают шанс превратить этот вопрос в экспериментальную задачу. Модель, обученная на текстах эпохи, фиксирует статистику совместной встречаемости слов, ассоциативные цепочки, иерархии смыслов. LLM — это математический слепок дискурса, застывшая форма языковой культуры. А раз это слепок — с ним можно экспериментировать.
В отличие от существующих методов интервенции в языковые модели (RepE, Causal Tracing, Concept Erasure), которые нацелены на контроль поведения, точечное редактирование фактов или удаление нежелательной информации, предлагаемый подход — E‑CDP — решает иную задачу: он дообучает модель на намеренно искажённых текстах, чтобы сравнить поведение полученных версий с контрольной и измерить системный эффект деформации. Это позволяет оценить, насколько глубоко понятие встроено в смысловую структуру дискурса. Подробное сопоставление с другими методами дано в онлайн-приложении [1, раздел /related_work].
2. Суть метода E-CDP
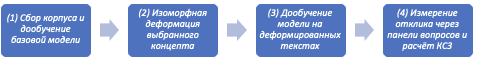
Протокол контролируемой деформации (Extended Controlled Deformation Protocol) состоит из четырёх этапов. Технические подробности — в онлайн-приложении [1]. Общая схема метода представлена на рис. 1.
2.1. Создание дискурсивной модели
Исследователь собирает корпус текстов, репрезентирующих культурный срез (исторический период, идеологию, национальную традицию). Базовая LLM дообучается на этом корпусе, впитывая характерные смысловые связи. Так получается «модель дискурса».
2.2. Изоморфная деформация концепта
Ключевая инновация. Для выбранного концепта создаётся короткий эталонный текст. Затем генерируются две деформированные версии: с редукцией (упрощением до бессодержательных тезисов) и с противоречиями (внесением взаимоисключающих утверждений). Критически важно, что синтаксис и грамматика сохраняются, а ключевые слова заменяются на псевдослова — грамматически согласованные, но семантически пустые единицы. Например, тезис «История всех обществ была историей борьбы классов» превращается в изоморфную бессмыслицу: «Капуста каждых утюгов являлась черникой люстры огурцов». Это исключает влияние стилистических артефактов на поведение модели.
2.3. Дообучение модели на деформированных текстах
Модель дообучается на каждом деформированном тексте с помощью технологии LoRA — быстрой адаптации, не требующей перезаписи всех весов.
2.4. Измерение системного отклика
Эксперты формируют панели бинарных вопросов (ответ «Да»/«Нет»): целевые — проверяют понимание деформируемого концепта; контрольные — из той же области, но не связанные с деформируемым концептом. Протокол валидации вопросов описан в [1, раздел /valid_quest].
Обе версии модели тестируются. По доле правильных ответов рассчитываются индексы:
- Индекс семантического сдвига (ИСС): относительное падение точности на целевых вопросах.
ИСС = (Acc_баз_цел − Acc_деф_цел) / Acc_баз_цел
- Индекс стабильности (ИС): изменение точности на контрольных вопросах (должен быть близок к нулю).
ИС= Acc_баз_контр − Acc_деф_контр
- Коэффициент структурной значимости (КСЗ): сумма ИСС по всем типам деформации.
КСЗ= ИСС_редукция + ИСС_противоречие
КСЗ показывает, насколько деформация концепта нарушила связность дискурса в модели. Чем выше КСЗ — тем более структурно значим концепт.
На начальном этапе, до накопления статистики, значимым предлагается считать расхождение более 10% по ИСС и КСЗ, превышающее уровень шума. Рекомендации по статистической оценке даны в [1, раздел /metrics].
3. Что даёт сравнение: иллюстративный пример
Полный разбор — в [1, раздел /pilots].
В пилотном (пока гипотетическом) исследовании взят корпус классического либерализма и проверены концепты: «Справедливость», «Равенство», «Свобода», «Частная собственность». Интуитивно ожидалось, что «Свобода» и «Справедливость» окажутся ключевыми.
Результаты (гипотетические, с намеренно внесённым шумом):
| Концепт | ИСС (редукция) | ИСС (противоречие) | КСЗ |
| Справедливость | 0.21 | 0.50 | 0.71 |
| Равенство | 0.24 | 0.55 | 0.79 |
| Свобода | 0.36 | 0.66 | 1.02 |
| Частная собственность | 0.11 | 0.42 | 0.53 |
Точность на контрольных вопросах колебалась в пределах 84–89%, падение не превышало 4%. «Свобода» подтвердила ожидания, но «Равенство» неожиданно обошло «Справедливость» (хотя их интервалы могут пересекаться — для уверенных выводов нужны реальные замеры). Метод указывает на неочевидную гипотезу: в либеральном корпусе «Равенство» может быть более структурно связующим, чем «Справедливость». Именно ради таких указаний и создавался E-CDP.
Главная сила метода — в сравнении множества концептов. Когда исследователь «прозванивает» десятки понятий, разница в их КСЗ формирует карту структурной топологии дискурса, выявляя узлы, важность которых не лежит на поверхности. Мы рекомендуем не останавливаться на разовом сравнении, а проектировать исследовательскую динамику: варьировать корпусы, концепты, типы деформаций и формулировки вопросов. Накопление множественных замеров открывает путь к многомерному сетевому анализу сдвигов.
4. Применения: от идеологий до педагогики
E-CDP — экспериментальная рамка, приложимая к разным задачам. Перечисленные сценарии являются проективными; их реализация требует пилотной проверки.
- Политическая социология: построение карты связности идеологии, выявление несущих и периферийных понятий.
- Историческая текстология: сравнение КСЗ одного концепта на корпусах разных эпох даёт траекторию его значимости во времени.
- Кросс-культурная компаративистика: сравнение КСЗ универсальных категорий в моделях разных языков выявляет зоны семантической жёсткости.
- Литературоведение: проверка гипотез о роли метафор, жанровых маркеров, идиостиля.
- Педагогика: выявление понятий, критически важных для усвоения предмета.
- Юридическая лингвистика: оценка устойчивости правовых дефиниций.
- Анализ пропаганды: определение понятий, на которых держится нарратив.
Метод не заменяет традиционные гуманитарные практики, а генерирует проверяемые гипотезы.
5. Границы валидности и ограничения
Что мы измеряем. КСЗ — операциональная метрика структурной связности концепта в данном текстовом корпусе, зафиксированной данной моделью. Это не онтологическая «важность» понятия в культуре.
Запрет на антропоморфизацию. Некорректно описывать реакцию модели в психологических терминах. Речь идёт о перераспределении вероятностей токенов.
Ограничения:
- Результаты зависят от качества экспертных вопросов и эталонных ответов.
- Разные LLM на одном корпусе могут дать разный КСЗ; необходимы повторные замеры.
- Репрезентативность корпуса определяет репрезентативность выводов.
- Возможны случаи, когда КСЗ не отражает реальную структурную значимость из-за особенностей корпуса, модели, языка или неудачно подобранных вопросов. Метод может давать невалидные результаты в конкретных конфигурациях; контрольные тесты разрабатываются [1, раздел /control].
- Требуется контроль артефактов, связанных с реакцией модели на псевдослова.
6. Перспективы развития
E-CDP находится в начале пути. Первые эксперименты идут, предварительные результаты обнадёживают, но полные данные ещё готовятся (см. препринт Смирнов, 2026 и будущие публикации в /pilots). В ближайших планах — публикация открытых датасетов и библиотеки кода, автоматизирующей рутинные этапы.
Мы планируем наращивать число целевых вопросов (до 500+) для повышения статистической устойчивости. Параллельно ведётся работа над выделением инвариантного ядра вопросов — структурно универсальной системы, применимой к разным концептам и корпусам. В наших текущих экспериментах уже заметна структурная схожесть; на её основе создаётся нейросетевая надстройка, ускоряющая генерацию валидных вопросов. Роль эксперта остаётся обязательной, полная автоматизация не предполагается.
По мере накопления данных мы перейдём к многомерному сетевому анализу сдвигов. Онлайн-приложение [1] будет развиваться как живая платформа для накопления результатов и обсуждений.
7. Заключение
Метод E-CDP предлагает гуманитариям инструмент, позволяющий ставить эксперименты над «слепками» культурных эпох. Вместо вопроса «как часто понятие встречается?» мы задаём вопрос «что произойдёт, если его смысл исказить?» — и измеряем ответ.
Детальные протоколы, технические спецификации и код вынесены в открытое онлайн-приложение [1]. Мы приглашаем коллег к дискуссии и сотрудничеству.
Ссылка на онлайн-приложение
[1] E-CDP Online Appendix. URL: [https://crcg.ru/e-cdp-appendix]. Разделы: /tech, /valid_quest, /pilots, /metrics, /related_work, /control, /corpus, /roadmap, /glossary, /faq, /contact.
Литература
- Смирнов А. Ю. Архитектоника семантических представлений: экспериментальный протокол выявления структурно значимых доменов в больших языковых моделях // Препринт Zenodo. — 2026. — DOI: 10.5281/zenodo.21205430.
- Zou A., Phan L., Chen S. et al. Representation Engineering: A Top-Down Approach to AI Transparency // arXiv:2310.01405. — 2023.
- Elhage N., Nanda N., Olsson C. et al. A Mathematical Framework for Transformer Circuits // Anthropic. — 2021.
- Meng K., Bau D., Andonian A., Belinkov Y. Locating and Editing Factual Associations in GPT // arXiv:2202.05262. — 2022.
- Belrose N., Schneider-Joseph D., Ravfogel S. et al. LEACE: Perfect Linear Concept Erasure in Deep Neural Networks // arXiv:2306.03819. — 2023.
- Hu E. J., Shen Y., Wallis P. et al. LoRA: Low-Rank Adaptation of Large Language Models // arXiv:2106.09685. — 2021.
- Dettmers T., Pagnoni A., Holtzman A., Zettlemoyer L. QLoRA: Efficient Finetuning of Quantized LLMs // arXiv:2305.14314. — 2023.
- Moretti F. Distant Reading. — London: Verso, 2013.
- Kozlowski A. C., Taddy M., Evans J. A. The Geometry of Culture: Analyzing Meaning through Word Embeddings // American Sociological Review. — 2019. — Vol. 84, No. 5. — P. 905–949.
- Karjus A. Machine-assisted quantitizing designs: augmenting humanities and social sciences with artificial intelligence // Humanities and Social Sciences Communications. — 2025. — Vol. 12. — Article 277.
- Choi G., Kim H. Automated Claim–Evidence Extraction for Political Discourse Analysis: A Large Language Model Approach to Rodong Sinmun Editorials // Proceedings of FEVER. — Vienna, 2025. — P. 1–17.
- Walker V., Angst M. Promises and pitfalls of using LLMs to identify actor stances in political discourse // PLOS ONE. — 2025. — Vol. 20(11). — e0335547.
- Bender E. M., Gebru T., McMillan-Major A., Shmitchell S. On the Dangers of Stochastic Parrots: Can Language Models Be Too Big? // Proceedings of FAccT. — 2021. — P. 610–623.
- Geiger A., Wu Z., Lu H. et al. Inducing Causal Structure for Interpretable Neural Networks // arXiv:2112.00826. — 2021.
- Vig J., Gehrmann S., Belinkov Y. et al. Causal Mediation Analysis for Interpreting Neural NLP: The Case of Gender Bias // arXiv:2004.12265. — 2020.