Страница проекта. Методология, данные и практические приложения
🌐 Read an abridged version in English
«Оцифровка культурного кода» — междисциплинарный исследовательский проект на стыке цифровой гуманитаристики, психологии самоопределения и литературоведения.
Цель проекта — разработать и валидировать методологию автоматизированного извлечения жизненных сценариев, картин мира и оценок прожитой жизни литературных персонажей из русскоязычных текстов 1800–2025 гг. с помощью больших языковых моделей (LLM).
В основе проекта лежит представление о художественной литературе как об архиве и симуляторе культурных моделей жизни: писатели редуцируют поведенческие паттерны до чистых семантических структур, которые общество бессознательно использует как матрицы для самоопределения. Оцифровав эти структуры через систему измеримых шкал, мы получаем карту сценарного ландшафта культуры — пригодную как для научного анализа, так и для практической работы.
На этой странице собраны материалы, дополняющие основную публикацию: полные тексты промптов, протокол экспертной валидации, описание практической модели, открытый датасет и техническая документация.
Хроника проекта
Текущий статус: v3.2 · пилот на 300 книгах (валидация) · онлайн-приложение (Сценарный контраст. P-300:v3.1)· 1 методический кейс-репорт
Проект развивается: калибруются промпты, расширяется пилотная выборка, публикуются кейсы валидации. Хроника фиксирует версии, решения и открытые вопросы — чтобы методология оставалась прозрачной, а результаты воспроизводимыми.
Основная публикация
Название: Оцифровка культурного кода: автоматизированное извлечение жизненных сценариев из русскоязычной литературы 1800–2025 гг. с помощью больших языковых моделей (методология, пилот-300, инфраструктура валидации). Версия 5.4.
Автор: А.Ю. Смирнов, научный руководитель АНО «Центр научных исследований в сфере профориентации и психологии труда».
Аннотация (кратко). В статье представлена методология автоматизированного извлечения жизненных сценариев, картин мира и оценок прожитой жизни из русскоязычной литературы 1800–2025 гг. Архитектура включает четырёх независимых LLM-агентов (социально-ситуационный, поведенческий, психологический, социокультурный), каждый из которых работает с полным текстом книги в едином контекстном окне по двухэтапной схеме (журнал наблюдений → дискретная оцифровка), и пятого агента-синтезатора, проводящего кросс-валидацию и вычисляющего интегральный индекс надёжности как минимум по шкалам. Предложены 10 измеримых шкал с многомерной операционализацией (декларация / поведение / внутренняя позиция, доменизация кризисов, амбивалентность авторского вердикта, горизонт замысла). Представлены результаты методического пилота на шести кейсах (включая два краш-теста) и пилота-300: 300 профилей, 78% проходят порог надёжности 2.8; Gap_Flag зафиксирован у 65% профилей. Введена трёхуровневая система валидации (текст / эксперт / автор). Описана открытая инфраструктура: датасет на Zenodo (срез 1901–1925, CC BY 4.0), приложение для исследователей со слепой валидацией, «Сценарный контраст» для профориентации подростков. Обсуждаются границы применимости, план на 10 000 текстов и кросс-культурная переносимость.
Ключевые слова: Оцифровка культурного кода, жизненные сценарии, картина мира, оценка прожитой жизни, большие языковые модели, корпусный анализ, русскоязычная литература, цифровая гуманитаристика, культурный анализ, открытые данные, культурные паттерны, самоопределение, многоагентный LLM-пайплайн, прикладные инструменты профориентации.
DOI: 🌐 https://doi.org/10.5281/zenodo.23560692 📄 Скачать статью в pdf.
(предыдущая версия 4.5 — в архиве проекта ↓).
Архитектура и система шкал
Как устроен пайплайн
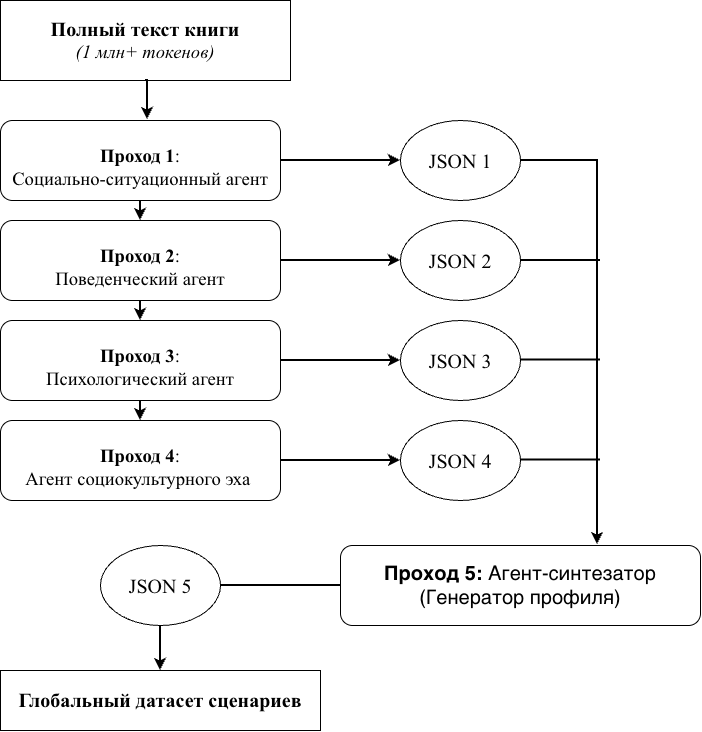
Анализ одного произведения выполняется пятью последовательными проходами. Первые четыре агента — социально-ситуационный, поведенческий, психологический и социокультурный — работают независимо, каждый с полным текстом книги в собственном контекстном окне (от 1 млн токенов). Каждый проходит две стадии в одном окне: сначала формирует журнал наблюдений с обязательными цитатами, затем выставляет дискретные оценки по закреплённым за ним шкалам, не возвращаясь к сырому тексту. Пятый агент — синтезатор — книгу не читает: он работает с журналами предыдущих проходов, проводит кросс-валидацию, вычисляет интегральный индекс надёжности и формирует итоговый профиль.
Отказ от промежуточной суммаризации — принципиальное решение: любая выжимка теряет психологический подтекст. Обязательная цитатная база делает каждое утверждение проверяемым, а кросс-валидация превращает расхождение между журналами из ошибки в диагностический сигнал.
Схема пайплайна
Система шкал: 10 измеримых параметров в четырёх блоках
| Переменная | Русское название | Блок | Значения |
Scale_of_Goals | Масштаб жизненных задач | I. Динамика и вектор судьбы | 1 — локальный; 2 — социально-статусный; 3 — глобальный (+ Gap_Flag) |
Social_Radius | Радиус социальной ориентации | I | 1 — эго; 2 — микро; 3 — мезо; 4 — макро (+ Perceived_Inclusion, Gap_Flag) |
Scenario_Final | Сценарный финал | I | 1 — крах; 2 — стагнация; 3 — триумф (+ Closure) |
Type_of_Agency | Тип субъектности | II. Кинематика действий | 1 — пассивный; 2 — реактивный; 3 — проактивный |
Crisis_Strategy | Стратегия преодоления кризиса | II | Пять доменов (идеологический, любовный, экзистенциальный, социальный, профессиональный); в каждом: борьба / избегание / конформизм / NA |
Scenario_Autonomy | Сценарная автономия | II | 1 — колея; 2 — контр-сценарий; 3 — альтернатива (+ Degree 0.0–1.0) |
Locus_of_Control | Локус контроля | III. Операционная система личности | Internal / External (+ Gap_Flag) |
Cognitive_Flexibility | Когнитивная гибкость | III | 1 — ригидность; 2 — вынужденная лабильность; 3 — осознанная эволюция (+ Evaluability) |
Social_Validation | Социальная валидация | IV. Культурное эхо | По группам (семья, сословие, общество): принятие / отвержение / игнорирование / NA (+ Dominant, Salience) |
Author_Verdict | Авторский вердикт | IV | К персонажу и к его программе: сочувствие / ирония / нейтральность (+ Counter_Verdict, Ambivalence_Level) |
Многомерные атрибуты (в скобках) — ключевое: они позволяют различать декларацию, поведение и внутреннюю позицию там, где одномерная шкала вынуждена выбирать один ярлык. Полные определения, примеры и таблица конфаундов — в статье (разделы 2.5 и 3.2) и в data_dictionary.md (датасет, Zenodo).
Технические характеристики
| Параметр | Значение |
| Модель | DeepSeek-R1 (Chain-of-Thought) |
| Контекстное окно | от 1 млн токенов (полный текст книги в одном окне) |
| Версия промптов | v3.2 (весь пилот-300 без промежуточных изменений) |
| Версия схемы данных | v1.3 |
| Объём пилота | 300 профилей персонажей, 1800–2025, семь исторических периодов |
| Профили с Total_Confidence_Score ≥ 2.8 | 234 (78%) |
| Профили с Gap_Flag = true (хотя бы одна из трёх шкал) | 195 (65%) |
| Датасет в доступе | срез 1901–1925, CC BY 4.0, Zenodo |
| Тип валидации | экспертная панель (6 кейсов) + слепая сетевая валидация (пилот-300) + авторская (точечно) |
Страница обновлена: 2026-10-22. Версии промптов, схемы и датасета фиксированы; при обновлении любого из них таблица пересматривается.
Инструменты проекта
«Сценарный контраст»: профориентация подростков
Инструмент сопровождения личностного и профессионального самоопределения, построенный на датасете пилота-300.
Это не тест и не диагноз.
Подросток настраивает абстрактного героя по семи шкалам — на языке, без психологических терминов: масштаб целей, радиус социальной ориентации, тип субъектности, стратегия преодоления кризисов, сценарная автономия, локус контроля, когнитивная гибкость. Три оставшиеся шкалы (финал, социальная валидация, авторский вердикт) не настраиваются, а наблюдаются: они вынесены в переключатели финалов и оценок. Система находит «литературных соседей» — персонажей из разных жанров и эпох, чьи сценарные профили близки, — и показывает, как при схожих настройках путь может заканчиваться крахом, застоем или триумфом; получать признание, отвержение или игнорирование; вызывать сочувствие, иронию или нейтральность автора.
Практический эффект трояк. Во-первых, подросток расширяет кругозор: вместо нескольких «популярных» книг он видит десятки произведений, объединённых близким ему сценарным каркасом. Во-вторых, он начинает воспринимать жизненные сценарии как вариативные и множественные — это само по себе инструмент рефлексии. В-третьих, он видит свои выборы в масштабе и понимает, что одинаковые настройки не гарантируют одинаковый финал.
Ключевые элементы: пульт из семи шкал с плашками расхождения («что говорит / что делает»); таймлайн эпох 1800–2025, который можно включать и выключать; распределение исходов в абсолютных числах и процентах; переключатели финалов и оценок; артефакт — профиль настроек и список литературы, который сохраняется и используется как материал для разговора с психологом; кабинет специалиста — маршрут прохождения и финальная конфигурация, без интерпретаций и автоматических выводов.
Модель проходит валидацию у педагогов-профориентологов и психологов.
🌐 Открыть «Сценарный контраст» →
📄 Подробное описание →
Приложение для исследователей
Среда воспроизводимости и коллективной валидации. Приложение решает три задачи.
Анализ. Фильтрация по эпохам, жанрам, статусу персонажа и порогу уверенности; карточки профилей с полной цитатной базой; сравнение в абсолютных и нормализованных значениях; динамика по всей линии времени с выбором эпох; экспорт в CSV. Любая конфигурация фильтров закрепляется в устойчивом URL, который можно переслать коллеге — он увидит ровно то же, что и вы.
Слепая валидация. Стандартизированная форма: эксперт оценивает произведение по 10 шкалам, не видя оценок LLM и ответов других экспертов. Ответы накапливаются по произведениям; агрегаты открываются после достижения порога накопления.
Прозрачность. Агрегированная статистика валидации (без индивидуальных оценок) доступна в приложении. Это позволяет проверять устойчивость выводов при разных порогах уверенности — читатель может воспроизвести любую конфигурацию и увидеть, как меняется выборка.
Для цитирования доступен фиксированный срез на Zenodo (эпоха 1901–1925).
Приложения
Приложение А. Промпты v3.2 (пять проходов)
Полные тексты инструкций для четырёх агентов и синтезатора, с описанием двухэтапной схемы (журнал наблюдений → дискретная оцифровка), правил заполнения многомерных полей и формата JSON-контракта.
🌐 Скачать промпты v3.2 (PDF) →
Приложение Б. Протокол экспертной валидации
Инструкции экспертам, дефиниции шкал, правила выставления оценок, процедура разрешения разногласий (консенсус большинства для категориальных шкал, медиана для ординальных, независимый арбитр при расхождении), форма сверки отчётов.
🌐 Открыть PDF с протоколом и промптом для сверки отчётов →
Приложение В. Кейс Медары: полный методический отчёт
Тройная валидация (LLM / эксперт / автор), таблица по 10 шкалам, диагностика расхождений, открытые вопросы. Включает ответ автора (с разрешения) и JSON экспертной разметки.
🌐 Перейти к кейс-репорту «Медара» →
Приложение Г. Приложение для исследователей: описание и функционал
Фильтры, карточки профилей с цитатной базой, форма слепой валидации, агрегированная статистика, устойчивые URL, экспорт в CSV.
Приложение Д. «Сценарный контраст»: описание праксиологической модели
Пульт настройки (семь шкал), «литературные соседи», переключатели финалов и оценок, артефакт, кабинет специалиста.
Приложение Е. Ссылка на датасет (Zenodo)
Срез 1901–1925, лицензия CC BY 4.0; data/*.json, dataset.json, manifest.csv, schema.json, data_dictionary.md.
Приложение Ж. Связь версий: промпты v3.2 → схема данных v1.3
Техническая таблица соответствия полей схемы и инструкций промптов; фиксация того, что весь пилот-300 выполнен на одной версии промптов без промежуточных изменений.
🌐 Перейти к Приложению Ж (PDF) →
🌐 Перейти к Приложению Ж (Markdown) →
Приложение З. Список литературы для пилота-300
🌐 Перейти к списку литературы (версия 2.1. ) →
Архив проекта
- Первоначальная публикация. «Автоматизированное извлечение жизненных сценариев из русской литературы с помощью больших языковых моделей (LLM): методология и границы применимости» (версия 4.5). DOI: 🌐 https://zenodo.org/records/22825133
- Промпты v1.0. Полные тексты системных промптов для пяти проходов (социально-ситуационный, поведенческий, психологический, социокультурный, синтезатор). 🌐 Открыть pdf с промптами версии 1.0.
- Промпты v2.0. Полные тексты системных промптов с учётом калибровки: трёхуровневая операционализация, доменизация кризисов, амбивалентность авторского вердикта. 🌐 Открыть pdf с промптами версии 2.0.
- Датасет (P-6, v1.1). Открытый датасет на Zenodo: JSON, все методические пилотные кейсы (P-6), включая краш-тесты. 🌐 Перейти к датасету на Zenodo. (Version 1.1)
Контакты
А.Ю. Смирнов, АНО «Центр научных исследований в сфере профориентации и психологии труда».
Email: smirnov@crcg.ru
Страница проекта: crcg.ru/ls-appendix
Хроники (дневник) проекта: crcg.ru/ls-project-log