Как устроен наш инструмент изнутри? В новой статье подробно разбираем «математику под капотом» онлайн-опросника: от современной модели описания профессий до алгоритмов расчета индекса соответствия.
Узнать о таксономии условий труда можно здесь. Использовать онлайн-опросник «Условия труда» здесь.
1. Что такое опросник «Условия труда»
Опросник «Условия труда» — это профориентационный инструмент, который помогает человеку понять, какие условия работы ему действительно подходят. Он опирается на 12 критериев, описывающих разные стороны трудовой деятельности: психическая нагрузка, физическая нагрузка, умственная нагрузка, ритм работы, экология, размер рабочего пространства и другие (подробное описание таксономии «Условий труда» есть в материалах по «Смысловой классификации профессий», ярус третий).
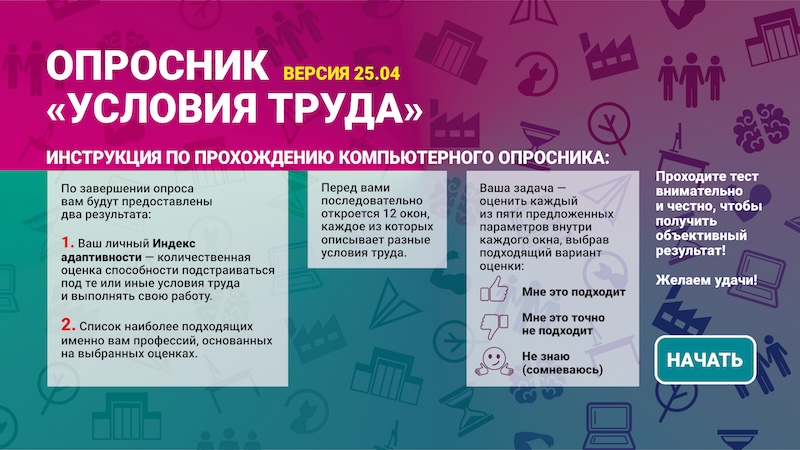
Каждый критерий представлен пятью степенями выраженности, от минимальной до максимальной. Например, критерий «физическая нагрузка» может принимать одно из пяти значений: минимальная, малая, средняя, большая, максимальная.
Пользователь (школьник, взрослый, выбирающий профессию) последовательно оценивает каждый из 60 параметров (12 критериев × 5 градаций) по трём вариантам:
- «Подходит» (для себя — хочу, чтобы в работе это было);
- «Не подходит» (не хочу, чтобы такое встречалось);
- «Не определился» (не знаю или безразлично).
Параллельно существует база данных профессий, в которой каждая профессия описана теми же 12 критериями и пятью градациями. На основании сравнения выборов пользователя и описаний профессий система вычисляет степень соответствия каждой профессии запросу человека и выдаёт три списка:
- 🟢 Зелёный — профессии, наиболее соответствующие предпочтениям;
- 🟡 Жёлтый — профессии, по которым нет ни явного совпадения, ни явного конфликта;
- 🔴 Красный — профессии, которые по условиям труда пользователю скорее не подходят.
Первая версия опросника использовала простую линейную модель расчёта. Её недостатки стали очевидны после нескольких лет практического применения. Настоящая работа описывает новую математическую модель, которая лишена этих недостатков, оставаясь при этом понятной даже тем, кто далёк от программирования.
2. Как работала первая модель и что пошло не так
Исходная модель была предельно прямолинейна. Пользователь делал 60 дискретных отметок (по каждой градации каждого критерия: «подходит» или «не подходит»). Профессия тоже была описана 60 бинарными метками: «свойственно» или «не свойственно».
При сравнении за каждое совпадение («подходит» и профессии это свойственно, либо «не подходит» и профессии это не свойственно) начислялось +2 балла. За каждое противоречие («подходит», но профессии не свойственно, или наоборот) — –1 балл. Если пользователь говорил «не определился» — 0 баллов.
Изначально все профессии имели «запас прочности» в 100 баллов, который уменьшался или увеличивался по итогам сравнения. Профессии, сохранившие 100 баллов, попадали в жёлтый список; набравшие больше 100 — в зелёный; опустившиеся ниже 100 — в красный.
Такая логика быстро проявила три системные проблемы:
Проблема 1: «мне всё равно» даёт штраф. Если пользователь в каком-то критерии отмечал как подходящие все пять градаций (давая понять: «этот критерий мне не важен, любой вариант устроит»), профессия получала +2 за одно совпадение и –1 за каждое из четырёх несовпадений, итого –2 балла. Критерий, который должен был «выключиться» из сравнения, начинал наказывать профессии.
Проблема 2: два соседних выбора ценились меньше, чем один. Если пользователь выбирал два соседних значения как подходящие (например, «малая» и «средняя» нагрузка), а профессия описывалась одним из них, совпадение было только по одному параметру — +2 балла, а по второму — –1 (так как профессия его не содержала). Суммарно получалось +1, хотя интуитивно хотелось бы +2: ведь профессия точно попала в «зону комфорта» пользователя.
Проблема 3: резкие скачки при множественных описаниях профессий. Эксперты заметили, что некоторые профессии не укладываются в одно-единственное значение критерия. Например, работа пожарного связана с физической нагрузкой от большой до максимальной. Если профессию описывали двумя метками («большая» и «максимальная»), то пользователь, выбравший оба этих значения, получал +4 балла; выбравший только одно — +2 –1 = +1. Разница в три балла только из-за того, нажал ли он «подходит» на обе градации или на одну, при том что оба ответа осмысленны.
Главная причина всех трёх проблем: модель считала попадания дискретно и равножестко, не различая «совсем не подходит» и «почти подходит, но чуть-чуть мимо». Она не умела работать ни с диапазонами предпочтений пользователя, ни с размытостью описания профессий.
3. Поиск альтернативы: векторный подход и коэффициент Жаккара
Чтобы преодолеть перечисленные ограничения, мы обратились к идее нечёткого сравнения. Вместо жёсткого «да/нет» мы решили описать профессию вектором из пяти чисел от 0 до 1, отражающих, насколько каждая градация выражена в данной профессии.
А выбор пользователя — тоже представить вектором, но уже расширенным: если пользователь выбрал, скажем, только «среднюю» нагрузку как подходящую, мы можем предположить, что «малая» и «большая» тоже отчасти приемлемы (допустим, с весом 0,5), а крайние значения — уже нет.
Тогда для каждого критерия можно вычислить нечёткий коэффициент Жаккара — меру сходства двух множеств, определяемую как отношение «пересечения» к «объединению». В мире нечётких множеств это отношение суммы минимумов к сумме максимумов по каждому элементу:
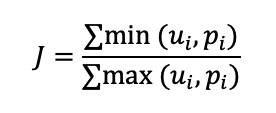
где ui — степень принадлежности градации к предпочтениям пользователя, pi — степень выраженности в профессии. Результат лежит в интервале [0, 1]: 1 — полное совпадение, 0 — полное расхождение.
Такой подход изящно решал проблему «размытых» описаний профессий и мог учитывать близкие значения без резких штрафов.
Однако углублённый анализ выявил два недостатка, которые для нашей задачи оказались критическими.
Во-первых, реальные описания профессий не бывают произвольными.
Практика экспертного оценивания сотен профессий показала: распределение выраженности любого критерия всегда компактно. Если профессии свойственна «большая» нагрузка, то «средняя» и «максимальная» могут быть выражены слабее, но не может быть так, что «минимальная» и «максимальная» выражены сильно, а «средняя» отсутствует. Иными словами, нечёткий Жаккар рассчитан на любые, сколь угодно причудливые векторы, а в нашем случае такой универсальности не требуется — все профили укладываются в небольшое число типовых форм.
Во-вторых, и это самое важное, расширение выбора пользователя нарушает валидность.
Пользователь в нашем опроснике не ставит «градусник» согласия, он выбирает из трёх чётких вариантов: «подходит», «не подходит», «не знаю». Приписывать ему «немного подходит» для соседней градации — значит додумывать за него. Система начинает опираться на данные, которые человек явно не давал.
В условиях, когда опросник заполняют подростки и взрослые, не всегда имеющие высокую рефлексию, такое домысливание способно исказить результат. К тому же педагогам и самим пользователям было бы трудно объяснить, почему профессия получила, скажем, 0,73 балла по критерию.
Поэтому мы отказались от нечёткого Жаккара в пользу более прозрачной дискретной модели, которая, тем не менее, полностью снимает недостатки первоначального подхода.
4. Новая модель: описание профессий, согласованность ответов и индекс контрадикторности
4.1. Как теперь описываются профессии
Каждая профессия по каждому критерию представляется вектором из пяти чисел в диапазоне от –1 до +1. Эти числа отражают не просто «наличие» условия, а его степень и направленность:
- +1 — ядро: градация, которая наиболее характерна для профессии;
- +0,5 — направленность: соседняя с ядром градация, которая тоже часто встречается, но не является основной;
- +0,3 — «тупик»: крайняя градация со стороны ядра (если ядро не на краю), выражена слабо, но допустима;
- 0 — нейтраль: градация практически не встречается, но и не является противопоказанием;
- –0,5 — «анти-направленность»: условие, скорее не свойственное профессии, тяготеющее к противоположному полюсу;
- –1 — полное отрицание: профессия точно не предполагает такой выраженности критерия.
Приведём конкретный пример. Критерий «размер рабочего пространства». Профессия «оператор беспилотной техники» (работа в помещении) может быть описана так:
| Минимальное | Малое | Среднее | Большое | Максимальное |
| +1 (ядро) | +0,5 | 0 | –0,5 | –1 |
Это означает: рабочее пространство в основном минимальное, иногда малое, большим и максимальным не бывает точно.
Все реальные профили укладываются в несколько типовых форм — ядро на одном из пяти делений и плавное затухание в одну или обе стороны. Это существенно упрощает и экспертизу, и расчёты.
4.2. Как интерпретируются ответы пользователя: согласованность и противоречия
Ответы пользователя остаются дискретными: +1 («подходит»), –1 («не подходит»), 0 («не определился»). Ключевое нововведение — мы теперь различаем согласованные и несогласованные наборы ответов внутри одного критерия.
Набор ответов считается согласованным, если все отмеченные «подходит» образуют непрерывный отрезок (или точку), а между «подходит» и «не подходит» нет логических противоречий.
Например:
- «+1» только на «средней» нагрузке, остальные «–1» — согласовано.
- «+1» на «малой» и «средней», остальные «–1» — согласовано (отрезок из двух соседних).
- «+1» на «минимальной», «малой» и «средней» — тоже согласовано.
Набор несогласованный, если выбранные «подходит» идут с разрывом (например, «минимальная» и «максимальная» одновременно) или если пользователь поставил «+1» на полюсах, а в середине «–1».
Такие ответы невозможно интерпретировать как осмысленный диапазон комфорта — скорее, они говорят о невнимательности или непонимании сути критерия.
Это разделение позволяет применять разную логику расчёта к «хорошим» и «плохим» ответам.
4.3. Расчёт соответствия для одного критерия
Для согласованных ответов мы вычисляем простую сумму по всем пяти позициям:
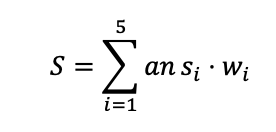
где ansi — ответ пользователя (+1, 0, –1), wi — вес профессии (от –1 до +1).
Произведение положительно, если желания пользователя и особенности профессии совпадают; отрицательно — если они в конфликте; ноль — если пользователь не определился или вес профессии равен нулю.
Чтобы оценки разных профессий были сравнимы, мы нормируем полученную сумму: делим её на максимально возможный балл для данной профессии при идеально согласованных с ней ответах (все «+1» на положительных весах и «–1» на отрицательных).
В результате нормированный показатель snorm всегда лежит в интервале [0, 1]. Единица означает идеальное совпадение, ноль — полный конфликт.
Для несогласованных ответов мы не пытаемся вычислить балл — это было бы математической фикцией. Вместо этого критерий исключается из усреднения (не влияет на итоговый рейтинг профессии), но фиксируется в специальном индексе, о котором ниже.
4.4. Индекс контрадикторности (ИК) и коэффициент доверия
Мы вводим Индекс контрадикторности (противоречивости) (ИК) — число, которое накапливается по всем 12 критериям и показывает, насколько ответы пользователя в целом «надёжны», не содержат ли они внутренних противоречий или зон неопределённости.
За каждый критерий начисляются баллы ИК по следующим правилам:
- Каждый ответ «не определился» (0) добавляет 0,1 балла (лёгкая неопределённость);
- Если пользователь выбрал все пять градаций как «не подходит» — +0,5 балла (отвергает всё — сомнительная позиция);
- Если выбраны все пять как «не определился» — +1,5 балла (полное отсутствие мнения);
- Если «подходит» образуют отрезок из четырёх соседних градаций, а оставшаяся — «не подходит» — +0,5 балла (пограничная ситуация);
- Если «подходит» идут с разрывом (несвязный выбор) — +5 баллов (явное противоречие, маркер неадекватного заполнения).
Таким образом, максимально возможный ИК составляет несколько десятков баллов (например, 12 критериев × 5 = 60, если везде разрывы).
Мы преобразуем ИК в коэффициент доверия (Confidence) по формуле:
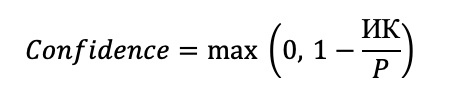
где P — пороговое значение (подбирается экспериментально, например, 20).
Если пользователь отвечал идеально непротиворечиво, ИК = 0, Confidence = 1. Если противоречий много и ИК достигает порога, Confidence обнуляется.
4.5. Итоговый показатель соответствия профессии
Сначала вычисляется сырой рейтинг профессии — среднее арифметическое нормированных баллов snorm по всем согласованным критериям. Критерии, признанные несогласованными, в это среднее не входят (они уже «наказали» пользователя через ИК).
Затем применяется коэффициент доверия:
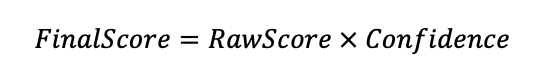
Таким образом, даже если по оставшимся критериям профессия подходит идеально (RawScore = 1), но пользователь допустил много противоречивых или неопределённых ответов, итоговый балл будет снижен. Это честный сигнал: «Ваши ответы недостаточно определённы, чтобы рекомендовать что-либо с высокой уверенностью».
4.6. Цветовые списки
На основе FinalScore, выраженного в процентах (0–100%), профессии распределяются по трём зонам:
- 🟢 Зелёный список: FinalScore ≥ 70% — профессии, хорошо соответствующие предпочтениям;
- 🟡 Жёлтый список: 40% ≤ FinalScore < 70% — профессии, для которых нет ни явного попадания, ни явного конфликта;
- 🔴 Красный список: FinalScore < 40% — профессии, условия труда которых противоречат желаниям пользователя.
При высоком ИК и низком Confidence даже объективно подходящие профессии могут сместиться в жёлтую или красную зону. В интерфейсе опросника пользователь увидит не только списки, но и свой персональный показатель определённости (например, «Ваша согласованность ответов: 85%»), что побудит его при необходимости пройти опрос более вдумчиво.
5. Ограничения и перспективы
Любая модель работает настолько хорошо, насколько качественны исходные данные. Описания профессий должны быть экспертными и регулярно актуализироваться. В нашем случае база профессий прошла многоступенчатую проверку, в том числе с привлечением больших языковых моделей для верификации согласованности описаний.
Трансформация профессий (как в примере с операторами дронов, переместившимися из кабины комбайна в помещение) требует периодического пересмотра профилей — это заложено в регламент сопровождения опросника.
Модель предполагает, что все 12 критериев равнозначны для пользователя. В будущем можно добавить возможность настройки личных весов критериев, но на данном этапе это оставлено за скобками, чтобы не перегружать интерфейс.
Наконец, модель сознательно отказывается от «подгонки» под любые, даже абсурдные ответы. Если пользователь хаотично кликает, индекс контрадикторности резко снизит доверие к результату — и это не баг, а предупреждение. Для большинства же пользователей, отвечающих осмысленно, новая система даёт более справедливые, плавные и объяснимые рекомендации.
6. Заключение
Мы заменили линейную балльную модель с жёсткими штрафами на дискретно-паттерновую модель с индексом контрадикторности. Она описывает профессии с помощью «размытых» весов, учитывает диапазонный характер предпочтений пользователя, явно разделяет согласованные и противоречивые ответы и вводит понятный показатель доверия к результату.
При этом расчёты остаются прозрачными: педагог всегда сможет объяснить ученику, почему та или иная профессия оказалась в зелёной или красной зоне, а система при необходимости укажет на несогласованность ответов.
Такой баланс между математической корректностью и человекочитаемостью делает новую версию опросника «Условия труда» надёжным инструментом профориентации.